MAGAZIN · AUS DER WERKSTATT
Vielleicht brauchen wir weniger neue Plattformen. Und mehr Systeme, die verstehen, was das andere bereits weiß.
Recruiting · Teil 3
Persönlicher Essay
6 Minuten Lesezeit
FORMAT
Aus der Werkstatt · Essay
TEXTSTAND
21. Oktober 2026
AUTOR
David Schmitt
In meinem ersten Essay habe ich den Bewerbungsportalen gratuliert. Im zweiten musste ich feststellen, dass mein KI-gestützter Job-Agent schneller arbeitet als die Prozesse, an die er seine Ergebnisse übergeben soll.
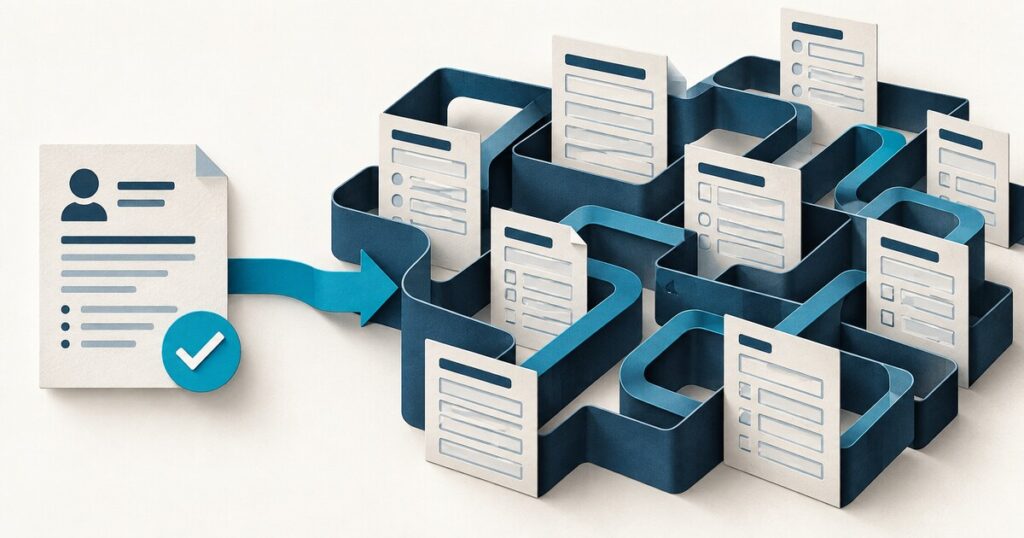
Inzwischen bedanken sich Unternehmen für meine Bewerbung – um mir anschließend zu erklären, dass ich mich bitte erst über ihr Portal bewerben soll.
Ich glaube, wir haben das Problem ausreichend besprochen.
Jetzt wird es interessanter.
Denn vielleicht sind die Bewerbungsportale gar nicht das eigentliche Problem.
Vielleicht ist unser größter Digitalisierungsfehler, dass wir immer noch glauben, jedes System müsse seine eigene kleine Welt sein.
Drei Postfächer. Eine ziemlich einfache Erkenntnis.
Ich habe drei E-Mail-Konten.
Eines für meine Selbstständigkeit. Eines für private Angelegenheiten. Eines für Bewerbungen.
Drei Systeme, drei Aufgaben, drei getrennte Informationsräume.
Natürlich könnte ich jeden Morgen drei Postfächer öffnen, Nachrichten sortieren, Zusammenhänge suchen und mir anschließend überlegen, was zu tun ist.
Oder ich baue eine Anwendung, die mir diesen unnötigen Zwischenschritt abnimmt.
Genau daraus entstand JARVIS Mail.
Ein Aggregator, der Informationen aus unterschiedlichen Konten zusammenführt, zuordnet und dort verfügbar macht, wo ich sie brauche.
Nicht, damit eine KI ungefragt meine Angelegenheiten regelt. Nicht, um drei funktionierende E-Mail-Systeme durch ein viertes zu ersetzen.
Sondern um eine gemeinsame Informationsgrundlage für meine Entscheidungen zu schaffen.
Der Ansatz funktioniert in diesem Anwendungsfall bereits.
Und irgendwann stellte ich mir eine Frage:
Wenn das mit meinen E-Mails funktioniert – warum sollte das Prinzip nicht auch mit Bewerbungen funktionieren?
Wir haben doch bereits gelernt, Dokumenten das Lesen beizubringen.
Nehmen wir die E-Rechnung.
Früher bekam man eine Rechnung als PDF. Ein Mensch konnte sie lesen, eine Maschine musste die Informationen häufig erst mühsam herausfiltern.
Heute gibt es beispielsweise ZUGFeRD.
In seiner hybriden Variante: ein menschenlesbares PDF/A-3 mit eingebetteten, maschinenlesbaren XML-Daten.
Das Dokument bleibt verständlich. Seine Informationen werden gleichzeitig strukturiert und automatisiert verarbeitbar.
Zugegeben: Eine Bewerbung ist keine Rechnung.
Aber warum sollte das technische Grundprinzip nicht übertragbar sein?
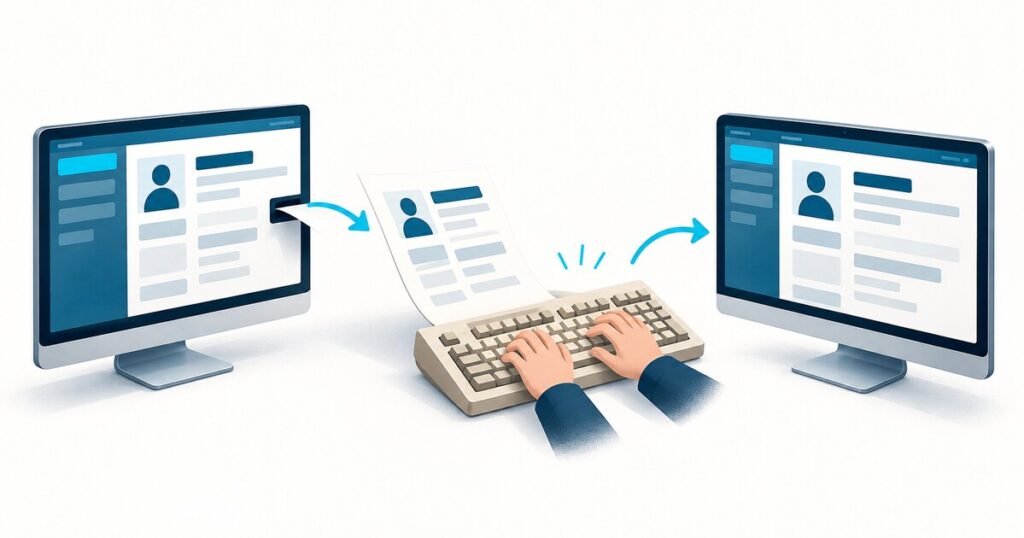
Ein Lebenslauf als PDF, ergänzt um strukturierte Daten: Berufsstationen, Zeiträume, Qualifikationen, Kontaktdaten, Fähigkeiten.
Der Mensch sieht einen Lebenslauf.
Das empfangende System erhält Informationen, die es direkt seinen Feldern zuordnen kann.
Natürlich bräuchte eine solche E-Bewerbung einheitliche Definitionen und Regeln. Die gibt es nicht automatisch, nur weil wir XML verwenden.
Aber genau solche Regeln lassen sich definieren.
Und wenn jemand weiterhin einen klassischen Lebenslauf verschickt?
Dann übernimmt eine vorgeschaltete Bridge die Aufbereitung. Texterkennung, KI-gestützte Extraktion, Plausibilitätsprüfung, strukturierte Ausgabe.
Nicht jede Angabe wird eindeutig sein. Dann wird sie eben zur Prüfung markiert.
Warum sollten Menschen Informationen erneut eintippen, die eine Maschine längst lesen kann?
Die eigentliche Idee ist größer als Recruiting.
Hier kommt meine Hypothese.
Ein System nimmt Informationen entgegen.
Ein anderes System benötigt diese Informationen nach bestimmten Regeln.
Dazwischen existiert eine Übergabe, die bislang nicht oder nur umständlich funktioniert.
Warum sollte sich diese Übergabe nicht durch eine entsprechend konfigurierte Bridge abbilden lassen?
Das Prinzip ist denkbar einfach:
Eingang verstehen. Informationen strukturieren. Regeln prüfen. Sauber übergeben.
Was dabei herauskommt, kann XML sein. JSON. Eine Schnittstellenanfrage. Ein kompatibles Importformat.
Das hängt vom Zielsystem ab.
Und natürlich müssen die Daten zugänglich, die Übergabe zulässig und die Anforderungen hinreichend bekannt sein. Andernfalls haben wir ein anderes Problem zu lösen.
Aber das ändert nichts am Grundgedanken.
Ich muss nicht die Buchhaltungssoftware neu erfinden, um Rechnungsdaten zu übergeben.
Ich muss kein neues Bewerbermanagementsystem bauen, um Bewerberdaten bereitzustellen.
Und ich musste keine drei neuen E-Mail-Dienste entwickeln, um meine Nachrichten zusammenzuführen.
Vielleicht sollten wir aufhören, ständig komplette Ökosysteme neu bauen zu wollen, wenn eigentlich nur eine Verbindung fehlt.
Governance by Design. Legal by Design. Von Anfang an.
An dieser Stelle kommen gewöhnlich die berechtigten Einwände.
Datenschutz. Compliance. Aufbewahrungsfristen. Zugriffsrechte. Berechtigungen. Verantwortlichkeiten.
Alles wichtig.
Aber warum behandeln wir diese Anforderungen so häufig, als wären sie Überraschungen, die erst nach der Entwicklung auftauchen?
Sie gehören an den Anfang.
Welche Informationen braucht das System wirklich?
Wer darf darauf zugreifen?
Auf welcher Rechtsgrundlage werden sie verarbeitet?
Wie lange werden sie benötigt?
Welche Prüfungen und Protokolle sind notwendig?
Wann werden sie gelöscht?
Vielleicht benötigt eine kleine Bridge überhaupt keine dauerhafte Datenspeicherung. Vielleicht verarbeitet sie Informationen nur für eine Übergabe und löscht temporäre Kopien anschließend automatisch.
Wo Aufbewahrungs- oder Nachweispflichten bestehen, berücksichtigen wir diese selbstverständlich.
Ein täglicher Wipe ersetzt keine rechtliche Prüfung. Aber Datenminimierung und automatische Löschung können sehr wohl Teil der Architektur sein.
Governance by Design und Legal by Design bedeuten nicht, möglichst viele Vorschriften nachträglich in Software zu gießen. Sie bedeuten, die relevanten Anforderungen vor der ersten Codezeile zu verstehen.
Das macht Projekte nicht automatisch größer.
Im Gegenteil.
Wer früh weiß, was sein System darf und können muss, kann vieles weglassen, was es niemals gebraucht hätte.
SMART statt Software-Monument.
Vielleicht ist das der Teil, der mir an solchen Ideen am besten gefällt.
Man muss daraus nicht sofort ein internationales Recruiting-Ökosystem mit eigener Plattform, Abonnementmodell und zwölf KI-Agenten entwickeln.
Man könnte einfach klein anfangen.
Ein Unternehmen. Ein Zielsystem. Ein festgelegtes Datenformat. Zehn fiktive Bewerbungen.
Dann formulieren wir ein konkretes Ziel: Welche Felder sollen zuverlässig übernommen werden? Wie messen wir Fehler? Was muss überprüft werden? Welcher Aufwand soll tatsächlich entfallen?
Spezifisch. Messbar. Erreichbar. Relevant. Terminiert.
SMART eben.
Ein kleines Projekt mit einem überprüfbaren Ergebnis.
Wenn es funktioniert, erweitern wir es.
Wenn es nicht funktioniert, wissen wir wenigstens konkret, warum.
Und wenn wir feststellen, dass die Lösung größer werden muss, dann bitte, weil die Anforderungen das tatsächlich verlangen.
Nicht, weil die Präsentation mit vierzig Folien sonst so leer aussieht.
Die beste Digitalisierung ist nicht zwangsläufig die mit dem größten Projektbudget. Sondern die, bei der hinterher weniger unnötige Arbeit übrig bleibt.
Meine Hypothese. Euer Gegenbeweis?
Mit diesem dritten Essay möchte ich meine kleine Recruiting-Serie abschließen.
Angefangen hat sie mit einem Bewerbungsportal.
Geendet ist sie bei einer grundsätzlicheren Überlegung über unsere digitalen Systeme.
JARVIS Mail ist für mich ein funktionierender Anwendungsfall des Aggregator-Prinzips. Die E-Bewerbung wäre eine mögliche Weiterentwicklung strukturierter Dokumente. Und eine Application Bridge könnte die Übergabe zwischen bereits vorhandenen Systemen übernehmen.
Dahinter steht eine größere Hypothese:
Überall dort, wo Informationen verfügbar sind, Übergaberegeln definiert werden können und die Verarbeitung zulässig ist, lässt sich dieses Prinzip grundsätzlich anwenden.
Nicht zwingend mit derselben Software. Nicht ohne Anpassungen. Und ganz sicher nicht immer mit demselben Aufwand.
Aber mit derselben Denkweise.
Deshalb interessiert mich weniger, ob jemand diese Idee gut findet.
Mich interessiert, wo sie scheitert.
Nicht, weil ein Unternehmen seine Schnittstelle nicht freigeben möchte. Nicht, weil zwei Datenformate unterschiedlich heißen. Und nicht, weil ein bestehender Prozess schon immer so funktioniert hat.
Das sind konkrete Einschränkungen, die man prüfen muss – keine Widerlegung des Prinzips.
Ich suche den Fall, in dem die Voraussetzungen gegeben sind und sich die Informationen trotzdem nicht sinnvoll übertragen lassen.
Und ich suche Unternehmen, die Interesse haben, diese Hypothese an einem echten Prozess mit mir zu testen.
Vielleicht finden wir eine überzeugende Gegenposition.
Vielleicht finden wir einen überraschend einfachen Lösungsweg.
Beides bringt uns weiter.
Meine These ist jedenfalls: Wir haben nicht unbedingt ein Digitalisierungsproblem. Wir haben ein Verbindungsproblem.
Und vielleicht sollten wir endlich anfangen, es als solches zu behandeln.
Denn eines möchte ich wirklich nicht mehr lesen müssen:
„Vielen Dank für Ihre Bewerbung. Bitte bewerben Sie sich.“
Dritter und abschließender Essay meiner Recruiting-Serie auf schmittAInander. Die E-Bewerbung und die Application Bridge sind konzeptionelle Übertragungen bestehender technischer Prinzipien. Ihre konkrete Umsetzbarkeit ist Gegenstand der Hypothese – nicht bereits bewiesen.